作者:Bryan Deep(BD103)。原文:C for Rust Programmers,发表于 2026 年 10 月 7 日。下文的「我」均指作者。
我最先学会的系统编程语言是 Rust。和其他程序员相比,这种经历不太常见;更容易遇到的是先学 C 或 C++,后来再学 Rust 的人。因此,网上有很多「写给 C 程序员的 Rust」文章,却很少看到「写给 Rust 程序员的 C」。
最近我开始学习 C 和 C++,也打算补上这个空缺。天哪,这两门语言可真够古怪的。这篇文章记录了我自学 C 时遇到的一些让人挑眉的细节。今天先不聊 C++,我还没准备好打开那一大罐虫子。这些笔记不能代替正式的 C 教程,教程还得自己用 Google 搜一下;这里列的是使用这门语言时需要记住的一些事情。
交代完背景,就拉开帷幕,看看 C 都有些什么吧!
Boolean 并非内置*
最早的 C 没有表示 Boolean 的基本类型,程序会用整数 0 和 1 代替。C99 改变了这一点:它引入了 _Bool 类型,而 <stdbool.h> 头文件提供了 bool、true 和 false 等宏。需要使用这些名字时,可以包含这个头文件[1]:
#include <stdbool.h>

int main() {
    bool yes = true;
    bool no = false;

    return 0;
}
不过,在 C99 至 C17 中,true 和 false 并不像其他语言那样是字面量或关键字,而是分别展开为 1 和 0 的宏定义:
#define true 1
#define false 0
到了 C23,这一点又变了[2]:bool、true 和 false 都成为语言本身提供的特性。但如果按更早的标准编译,又想使用这些名字,仍需要包含 <stdbool.h>。
以零字节结尾的字符串
在这里使用的 64 位目标平台上,Rust 的 &str 占 16 字节:其中 8 字节存内存地址,另外 8 字节存字符串的字节长度。这是因为 str 是动态大小类型(dynamically sized type),需要通过 pointer metadata 记录长度。具体字节数依赖目标平台;下面的断言也以这种 64 位布局为前提。
// While a normal reference uses only 8 bytes...
assert_eq!(std::mem::size_of::<&u8>(), 8);

// ...strings use 16 bytes.
assert_eq!(std::mem::size_of::<&str>(), 16);
这样获取字符串长度非常高效,但每个 &str 引用也需要更多内存。C 中以零字节结尾的字符串采用另一种方式:不单独保存长度,而是在每个字符串末尾放一个零字节(\0)。这种有意做出的取舍带来了几件事:
C 程序不必在字符串旁额外维护一个
size变量[3]。每个字符串末尾都要留出一个零字节的空间。
也就是说,即使是空字符串
"",也要占用 1 字节内存!
字符串中间不方便放入零字节,否则
<string.h>中按零字节判断结尾的函数会提前停止处理。忘记添加零终止符,可能引发越界读取。
实际写代码时,需要记得为零终止符多分配一点空间,并在字符串末尾写入它。例如,下面这个 C 函数会反转字符串:
char* reverse(char* forward) {
    // Calculate the string's length, excluding the null terminator.
    unsigned long len = strlen(forward);
    // Allocate enough room for the string and its null terminator.
    char* reversed = malloc(len + 1);

    for (int i = 0; i < len; i++) {
        reversed[i] = forward[len - 1 - i];
    }

    // Add the null terminator at the end.
    reversed[len] = '\0';

    return reversed;
}
留意第 5 行和第 12 行,它们专门处理了零终止符。作为对照,对应的 Rust 函数[4]就不需要这样做:
fn reverse(forward: &[u8]) -> Box<[u8]> {
    let len = forward.len();
    let mut reversed = Box::<[u8]>::new_uninit_slice(len);

    for i in 0..len {
        reversed[i].write(forward[len - 1 - i]);
    }

    unsafe { reversed.assume_init() }
}
随目标平台变化的整数位宽
C 的整数类型不保证固定的位宽,具体宽度会随目标平台变化。
| 类型 | C 标准要求的最小位宽 | 64 位 Unix(LP64) | 64 位 Windows(LLP64) |
char | 至少 8 位 | 8 位 | 8 位 |
short | 至少 16 位 | 16 位 | 16 位 |
int | 至少 16 位 | 32 位 | 32 位 |
long | 至少 32 位 | 64 位 | 32 位 |
long long | 至少 64 位 | 64 位 | 64 位 |
数据见 cppreference.com。表中的 Unix 和 Windows 列分别对应 LP64 与 LLP64 数据模型,不代表每种 64 位实现都使用同一套布局。
Unix 上的 long 是 64 位,Windows 上却是 32 位,这一点尤其让我烦躁。我建议采用一位朋友几年前给我的建议:如果在意跨平台兼容性,对需要确定位宽的整数,就使用 <stdint.h> 中实现提供的定宽类型。
| Rust | C |
u8 | uint8_t |
u16 | uint16_t |
u32 | uint32_t |
u64 | uint64_t |
usize | size_t[5] |
i8 | int8_t |
i16 | int16_t |
i32 | int32_t |
i64 | int64_t |
isize | ptrdiff_t[5] |
这里的 intN_t 和 uintN_t 属于可选的精确位宽类型;实现具有相应整数类型时才需要提供。size_t 和 ptrdiff_t 则由 <stddef.h> 定义,分别用于对象大小和指针相减的结果,不属于定宽整数;表中的对应关系也不是严格的语义等价。
错误处理真难用
我很喜欢 Rust 的错误处理。Result 会提醒你处理错误,而 sum types(和类型,也就是这里的 enum)与 match 让这件事很方便!更准确地说,直接忽略 Result 默认会触发编译器告警;它并不保证开发者一定处理了错误。
C 的错误处理就惨得多了。看起来,无非是让函数返回 -1 这样的「魔法整数」,或者用空指针表示出错。读取 errno 可以多得到一点信息:它是一个线程局部的整数,可用于区分某些错误。但要拿到具体的错误消息和 stack trace,就费劲得多。
写 C 时,很快就会注意到,语言本身不会强制你处理错误。函数可能失败,这件事得自己记住。比如,「以零字节结尾的字符串」一节有这样一段代码:
// Allocate enough room for the string and its null terminator.
char* reversed = malloc(len + 1);

for (int i = 0; i < len; i++) {
    reversed[i] = forward[len - 1 - i];
}
刚接触 C 时,不一定能立刻意识到 malloc() 也会失败并返回空指针。如果机器内存不足,分配失败后仍访问 reversed[i],就会触发 undefined behavior,可能表现为 segmentation fault。为了避免这种难以定位问题的崩溃,程序应检查返回值是否为空,并在发现失败时有序退出:
char* reversed = malloc(len + 1);

if (reversed == NULL) {
    perror("Error");
    exit(1);
}
这样得到的信息,比 segmentation fault,或者更糟糕的其他意外行为,清楚得多。下面是在设置了相应 errno 的系统上的输出示例;perror() 的具体文本取决于 errno 和系统环境,C 标准本身不保证 malloc() 失败会设置它。
$ ./main
Error: Cannot allocate memory
不过,每次都记得检查分配得到的指针,开发体验也谈不上好。我尝试过用 tagged union(带标签的联合体)在 C 中重新实现 Rust 的 Result:
struct MallocResult {
    enum Tag { OK, ERROR } tag;
    union Value {
        void* ptr;
        char* error_message;
    } value;
};
但用起来实在很麻烦,而且仍然没有什么能阻止你跳过错误处理,直接访问 result.value.ptr。C 没有 private、public 这类可见性修饰符,无法用它们拦住这种访问;在我看来,这似乎是有意为之。C 完全相信程序员会「把事情做对™」,却很少提供表达契约或构建安全抽象的语言机制。
我个人并不认同这种做法。我又不是一个永不犯错的编程大师。我更愿意把程序的要求写进类型系统,让编译器帮我检查[6]!这样,代码能编译通过时,我就能对它满足这些已编码的要求更有信心,尽管这不能保证所有行为都正确。话题扯远了。
字段访问语法
C 有两种字段访问运算符:访问值用 .,通过指针访问用 ->。
struct Foo {
    int field;
};

struct Foo value = { 103 };
struct Foo* ptr = &value;

// Accessing the field directly.
printf("%d\n", value.field);

// Accessing the field through a pointer.
printf("%d\n", ptr->field);
刚看到时,我完全没反应过来,因为 Rust 访问这些字段时用的都是 .。
配图出处。

如果好奇 -> 为什么存在,可以看看这篇 Stack Overflow 回答,里面讲了一些有趣的历史[7]。
数组怎么就变成指针了
数组也有一些古怪的细节。有时它是普通的数组值,可以用 sizeof() 得到所占的字节数;有时它却表现为不知道原数组大小的指针。下面的例子里,这种差异体现在:是在声明数组的函数内直接使用它,还是把它传给另一个函数。
下面这个简单的 C 程序会打印两个数组的大小:
char declared_size[3] = { 1, 2, 3 };
char inferred_size[] = { 4, 5, 6 };

printf("Declared size (main): %ld bytes\n", sizeof(declared_size));
printf("Inferred size (main): %ld bytes\n", sizeof(inferred_size));
sizeof 返回的是字节数,类型为 size_t;这里元素恰好都是 char,字节数才与元素个数相同。示例中的输出格式沿用 %ld;可移植的 size_t 输出应使用 %zu。
运行后,程序告诉我们,两个数组都占 3 字节。很好!
$ ./main
Declared size (main): 3 bytes
Inferred size (main): 3 bytes
现在稍微改一下:先把 declared_size 和 inferred_size 传给一个函数,再打印大小:
void function(char declared_size[3], char inferred_size[]) {
    printf("Declared size (function): %ld bytes\n", sizeof(declared_size));
    printf("Inferred size (function): %ld bytes\n", sizeof(inferred_size));
}
逻辑没有变化,数组也和上一个例子一样,可现在程序却说每个数组占 8 字节。下面的输出同样以指针占 8 字节的目标平台为前提:
$ ./main
Declared size (function): 8 bytes
Inferred size (function): 8 bytes
这是因为,在这种函数调用中,数组表达式会隐式转换成指向首元素的指针;而形参中的数组声明,也会被调整为指针类型。从 C 编译器的角度看,上面的函数签名实际上相当于:
void function(char* declared_size, char* inferred_size);数组表达式转换成指针的规则并不只发生在函数调用中;直接对数组使用 sizeof、取地址等则属于例外。因此,判断依据是表达式和类型规则,不能简单理解为「只要在定义数组的函数里,就一直是数组」。
所以才会看起来像是每个数组都长 8 字节。数组本身是 3 字节,但这里的指针占 8 字节!好在,对这种数组形参使用 sizeof() 时,Clang 会发出告警,让这个错误更容易被发现:
$ clang main.c
06-arrays/main.c:5:59: warning: sizeof on array function parameter will return size of 'char *'
      instead of 'char[3]' [-Wsizeof-array-argument]
    5 |     printf("Declared size (function): %ld bytes\n", sizeof(declared_size));
      |                                                           ^
06-arrays/main.c:4:20: note: declared here
    4 | void function(char declared_size[3], char inferred_size[]) {
      |                    ^
06-arrays/main.c:6:59: warning: sizeof on array function parameter will return size of 'char *'
      instead of 'char[]' [-Wsizeof-array-argument]
    6 |     printf("Inferred size (function): %ld bytes\n", sizeof(inferred_size));
      |                                                           ^
06-arrays/main.c:4:43: note: declared here
    4 | void function(char declared_size[3], char inferred_size[]) {
      |                                           ^
2 warnings generated.
对了,C 里没有引用
这个差异总得提一次。C 没有 borrow checking,也没有 Rust 那样的引用类型,用的都是 raw pointers。也就是说,可以做下面这种有趣的指针运算:
int array[] = { 0, 1, 2, 3, 4, 5 };

// Woah, iterating over pointers instead of indexes!
for (int* x = &array[0]; x < &array[6]; x++) {
    *x = 5 - *x;
}
不过,我也不确定这种做法到底好不好。😅
无论如何,操作指针时要小心。内存处理出错可能引发 buffer overflow 和越界写入,对代码安全构成严重威胁。
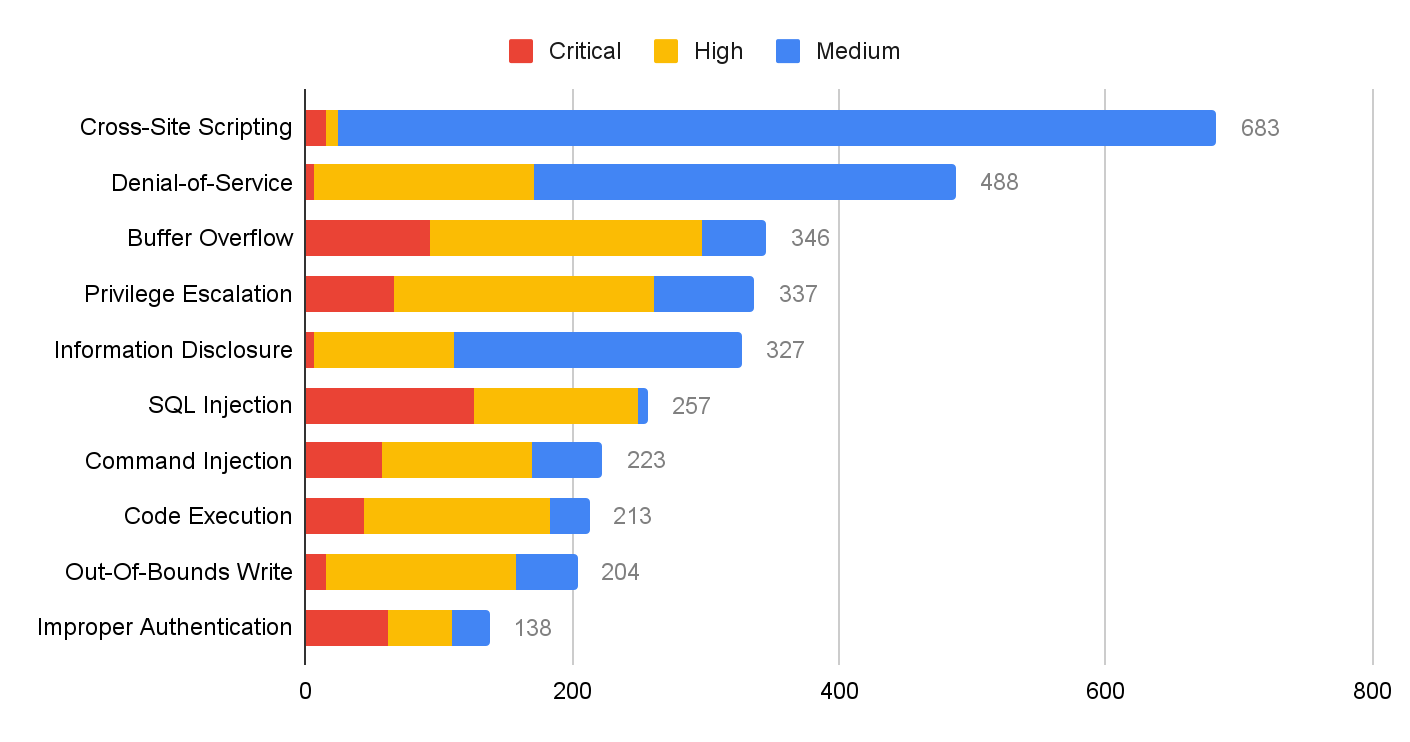
查看原尺寸图表。图表出处:Unit 42,Network Security Trends: November 2021 to January 2022;原文使用的图片。

结语
希望你喜欢这篇文章!学习 C 的过程确实很有趣。虽然我大概不会在个人项目中优先选择它,但我认为,它是系统程序员很有必要了解的一门语言。文中的全部示例都放在 GitHub 上,可以拿来自己试一试!
下次见,
—— BD103 :)
脚注
技术上,在 C99 至 C17 中,可以不包含头文件就使用
_Bool,但要使用true和false的宏定义,仍需要<stdbool.h>。↩看起来,Clang 对 C23 的支持仍不完整,所以在删除
#include <stdbool.h>之前,需要确认工具链和语言模式。不过,「整体支持不完整」不等于布尔关键字尚未实现;该状态页列出的true和false语言特性(N2935)自 Clang 15 起已获支持。↩如前面所说,Rust 实质上也是把指针和长度放在一起。在 C 中,手工维护这些内容会很麻烦;Rust 的语言特性则把它们结合起来,程序员不用把指针与字符串长度当成两个独立变量考虑。↩
对应的 Rust 函数并不符合惯用写法,而且作为文本反转只适用于 ASCII。如果要写一个用于实际项目的版本,我会用一行代码:
forward.chars().rev().collect::<String>()。这里按 Unicode scalar value 反转,并不保证组合字符等用户感知字符保持完整。↩usize和isize与size_t、ptrdiff_t并不是完全对应的语义关系。我也没有完全弄懂其中的差别,所以建议在使用这些类型前自己再查一查。↩ ↩2这篇关于 Fearless SIMD 的文章展示了如何利用 Rust 的类型系统保证代码满足相应的正确性要求,是个很好的例子。非常推荐读一读!↩
那篇回答里,我最喜欢的一行代码是
100->a = 0;,实在太诡异了!↩
技术核对资料
C11 Committee Draft N1570:布尔宏、整数类型、数组转换、内存分配和格式化输出规则。
C23 Working Draft N3096:
bool、true和false的语言支持。Rust
str文档:字符串切片的组成及字符迭代语义。Rust
Result文档:忽略Result默认触发告警的行为。Clang - C Programming Language Status:C 标准与相关语言特性的实现状态。